Показаны сообщения с ярлыком python. Показать все сообщения

среда, 22 августа 2012 г.

Python MIME-библиотека и строка From в Unix-стиле


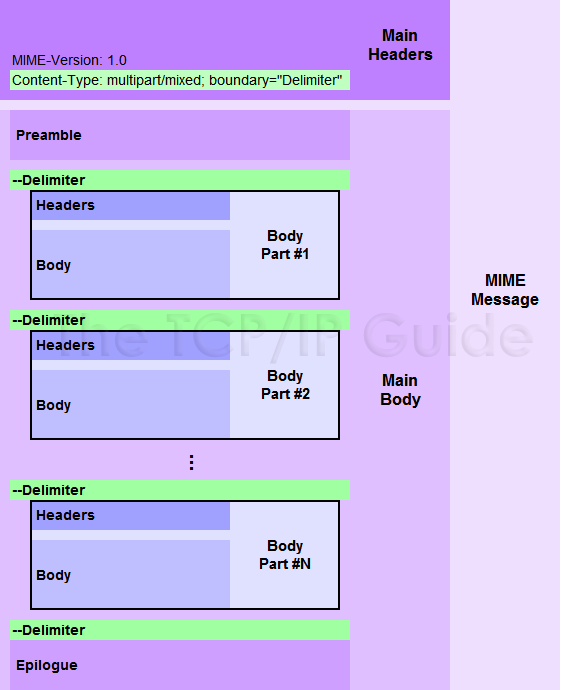
При создании тела письма с помощью питоновского класса email.message.Message (и его потомков типа email.mime.base.MIMEBase или email.mime.multipart.MIMEMultipart) первой строкой автоматически добавляется  знакомая каждому старому юниксоиду строка From без двоеточия.
Например:

$ python
>>> import  email.mime.multipart
>>> msg = email.mime.multipart.MIMEMultipart()
>>> print msg

From nobody Wed Aug 22 11:02:28 2012
Content-Type: multipart/mixed; boundary="===============1046125271=="
MIME-Version: 1.0

--===============1046125271==

--===============1046125271==--

Конечно всякий нормальный емейл-клиент реагирует на эту строку спокойно: ведь она существует в мире уже третий десяток лет, но - увы - современный мир полон ненормальными почтовыми клиентами. В одном из их - Lotus Notes 8.5.1 - наличие строки From в заголовке приводит к тому, что MIME-структура письма не отображается - и письмо выводится как простой текст.   
Как заставить Message не включать в письмо данную строку? В документации обнаружено два способа:
  1. прямой. Message имеет метод as_string(self, unix_fromline=False). Если в прошлом примере вместо print msg сделать print msg.as_string() (или - для не надеющихся на умолчательное поведение - print msg.as_string(False)), то мы получим текст сообщения без строки From.
  2. прикольный. Строку From можно заменить любой своей строкой - для этого у нашего класса есть метод set_unixfrom(self, string). Т.к. по стандарту мы можем беспрепятственно добавлять в письмо любые заголовки, начинающиеся с "X-", то сделав что-то типа: msg.set_unixfrom("X-Mailer: Python Is Not Lotu$ Note$") мы получим тело письма, которое ничем не смутит нашего капризного клиента. 

четверг, 30 декабря 2010 г.

Вызов mysql_use_result в Python-MySQL

Точно так же, как и Perl DBI, Python-MySQL по умолчанию использует API функцию mysql_store_result, что на больших объемах выборки (тестировалось с выборкой возвращающей 17 млн. записей) приводит к использованию невероятного количества памяти - и результатов работы скрипта можно не ждать - ибо система будет увлеченно занята копированием страниц из свопа - и в своп. Метод борьбы с этой бедой - тот же, что и в DBI - нужно использовать функцию mysql_use_result (плата за экономию ресурсов проста и жестока - пока result не закрыт, никакой другой запрос на этом подключении выполнить нельзя).
На практике делается это так. При использовании модуля MySQLdb вместо обычного вызова метода cursor() без аргументов пишем:
cu = db.cursor(MySQLdb.cursors.SSCursor)
Скажем несколько слов о поведении данного типа курсоров. Как легко догадаться, привычный вызов fetchall() делает курсор на серверной стороне абсолютно безсмысленным - так что нужно использовать fetchone(). Вот тут-то нас и поджидает небольшая засада - очевидный цикл:
for i in range(0, cu.rowcount):
как раз и не работает, ибо для SSCursor rowcount не определен. Для любителей чисто питонского цикла
for rw in cu:
сразу скажу, что данная конструкция, как ни странно, работает правильно. Так же можно организовать цикл способом аналогичным тому, который предлагается ниже для модуля _mysql.
Так вот, переходим к этому модулю. Выигрыш в производительности он дает выдающийся - на моей выборке быстрее раз в 5 (даже быстрее, чем аналогичный скрипт на Perl), так что ради таких выгод вполне можно потерпеть несколько зубодробительный синтаксис (тот, кто знаком с MySQL C API ничего страшного в этом синтаксисе не увидит).
Работаем оно так:
db.query("select * from sometable")
rs = db.use_result()
Все это еще не беда. Беда начинается дальше. rs.num_rows() по причинам, изложенным выше, не работает, а потому с циклом придется слегка повозиться. Python - это вам не C и не Perl - оператор присваивания внутри условия цикла не поддерживается, и потому нужно организовывать достаточно уродливый цикл (последний раз что-то подобное приходилось делать в языке 1С Бухгалтерии):

rw = rs.fetch_row()
while rw:
    # do something
    rw = rs.fetch_row()
На этом сюрпризы не заканчиваются. rw в этом примере - вовсе не tuple, состоящий из полей запроса, а tuple, состоящий tuples, состоящих из полей (к счастью, по умолчанию, там этот tuple строго один - для возврата нескольких строк за раз fetch_row нужно вызывать с аргументом maxrows - значение 0 означает "все"). Так что присваивание переменным значений полей будет выглядеть так:
fld1, fld2, fld3 = rw[0]
Еще нужно помнить, что если MySQLdb приводит типы данных MySQL к аналогичным типам Python, то в _mysql все данные - тупые строки (если я правильно помню, аналогичные функции C API ведут себя аналогично).